GUIA
Mean Time to Restore: O Que É e Como Calcular
Uma das 4 métricas DORA — quanto tempo um time leva pra se recuperar quando algo quebra em produção.
O que mede
Mean time to restore (MTTR, tempo médio de restauro) é o tempo médio entre um incidente começar e ser resolvido — do momento em que a produção quebra até o momento em que volta a funcionar. Das 4 métricas DORA, é a que responde uma pergunta diferente das outras três: frequência de deploy, lead time e change failure rate são todas sobre como você entrega; o MTTR é sobre o que acontece depois que algo dá errado mesmo assim, porque em algum momento sempre dá.
Por que importa
Nenhum time entrega mudanças com 0% de falha pra sempre — produção quebra às vezes, não importa o quão cuidadoso seja o processo. O que separa um time resiliente de um frágil não é se incidente acontece, é a velocidade com que o time percebe e se recupera. Um time com MTTR alto paga por cada incidente duas vezes: uma na própria indisponibilidade, e outra nas horas extras de apagar incêndio, escalar e investigar manualmente que um time mais rápido teria evitado. Ao longo de um ano, a diferença entre um MTTR elite e um lento é a diferença entre incidente virar um contratempo de terça à tarde ou virar uma revisão de incidente de vários dias.
O MTTR também é a métrica que torna entregar mais rápido genuinamente seguro de buscar. Um time que só acompanha frequência de deploy e change failure rate ainda pode se queimar entregando rápido se a recuperação for lenta — mais deploy significa mais chance de incidente, e se cada um leva dias pra resolver, a velocidade para de valer a pena. Acompanhar o MTTR junto das outras três é o que transforma "a gente entrega rápido" em "a gente entrega rápido e se recupera rápido quando importa".
Como calcular
Pega todo incidente resolvido num período, mede o tempo entre ele começar e ser resolvido, e tira a média dessas durações. As duas decisões que de fato mudam o número: onde o relógio começa — no momento em que o incidente foi disparado, ou no momento em que alguém o reconheceu — e onde ele para, geralmente quando o incidente é marcado como resolvido, não quando um conserto definitivo é entregue (um rollback que restaura o serviço conta, mesmo que o bug de fundo ainda não tenha sido corrigido).
Um exemplo rápido: um time resolve 6 incidentes num mês, com tempos de restauro de 0,5h, 1h, 1h, 2h, 4h e 40h — uma indisponibilidade longa. A média é 8,1 horas, puxada quase toda por esse incidente único. A mediana (o valor do meio, 1,5h) conta uma história bem diferente: a maioria dos incidentes é resolvida rápido, e um valor fora da curva está distorcendo a média. Os dois números são úteis — a média mostra o impacto total, a mediana mostra como é um incidente típico de verdade — por isso vale a pena olhar os dois em vez de escolher só um.
Elite vs. desempenho típico
A pesquisa da DORA também agrupa times em faixas aproximadas aqui. Times elite restauram o serviço em menos de uma hora, tipicamente. Times no meio do caminho levam algo entre um dia e uma semana. Times de desempenho mais baixo podem levar mais de uma semana. Assim como nas outras 3 métricas, trate isso como um sentido geral de onde um time está, não como um placar rígido — as faixas exatas mudaram um pouco entre diferentes anos do State of DevOps Report, e uma única indisponibilidade bem longa pode balançar uma média sem que a recuperação típica do time tenha piorado de verdade.
Uma armadilha comum
O jeito mais rápido de fazer o MTTR parecer melhor sem de fato melhorar a recuperação é começar o relógio tarde — medindo a partir do reconhecimento em vez de quando o incidente de fato começou. Isso pode ser uma escolha legítima (alguns times genuinamente não conseguem detectar um incidente antes que alguém perceba), mas vale ser honesto sobre qual dos dois você está medindo: "tempo até reconhecer e consertar" e "tempo desde o primeiro impacto até consertar" são números diferentes, e só o segundo reflete o que seus usuários de fato sentiram.
Como o moasy.tech calcula isso
O moasy.tech recalcula o MTTR automaticamente a partir de incidentes sincronizados somente leitura do Waroom ou incident.io — sem cronometragem manual, sem planilha. Qual timestamp inicia o relógio é configurável por time (disparo do incidente por padrão, ou reconhecimento em vez disso), com um padrão da empresa como fallback, pra a escolha ficar explícita em vez de enterrada numa fórmula que ninguém lembra de ter decidido. A média e a mediana do tempo de restauro aparecem lado a lado, com tendência, pra uma indisponibilidade ruim não se esconder silenciosamente atrás de um número só.
Veja as outras 3 métricas DORA no guia completo, ou a implementação completa na página de DORA Metrics.
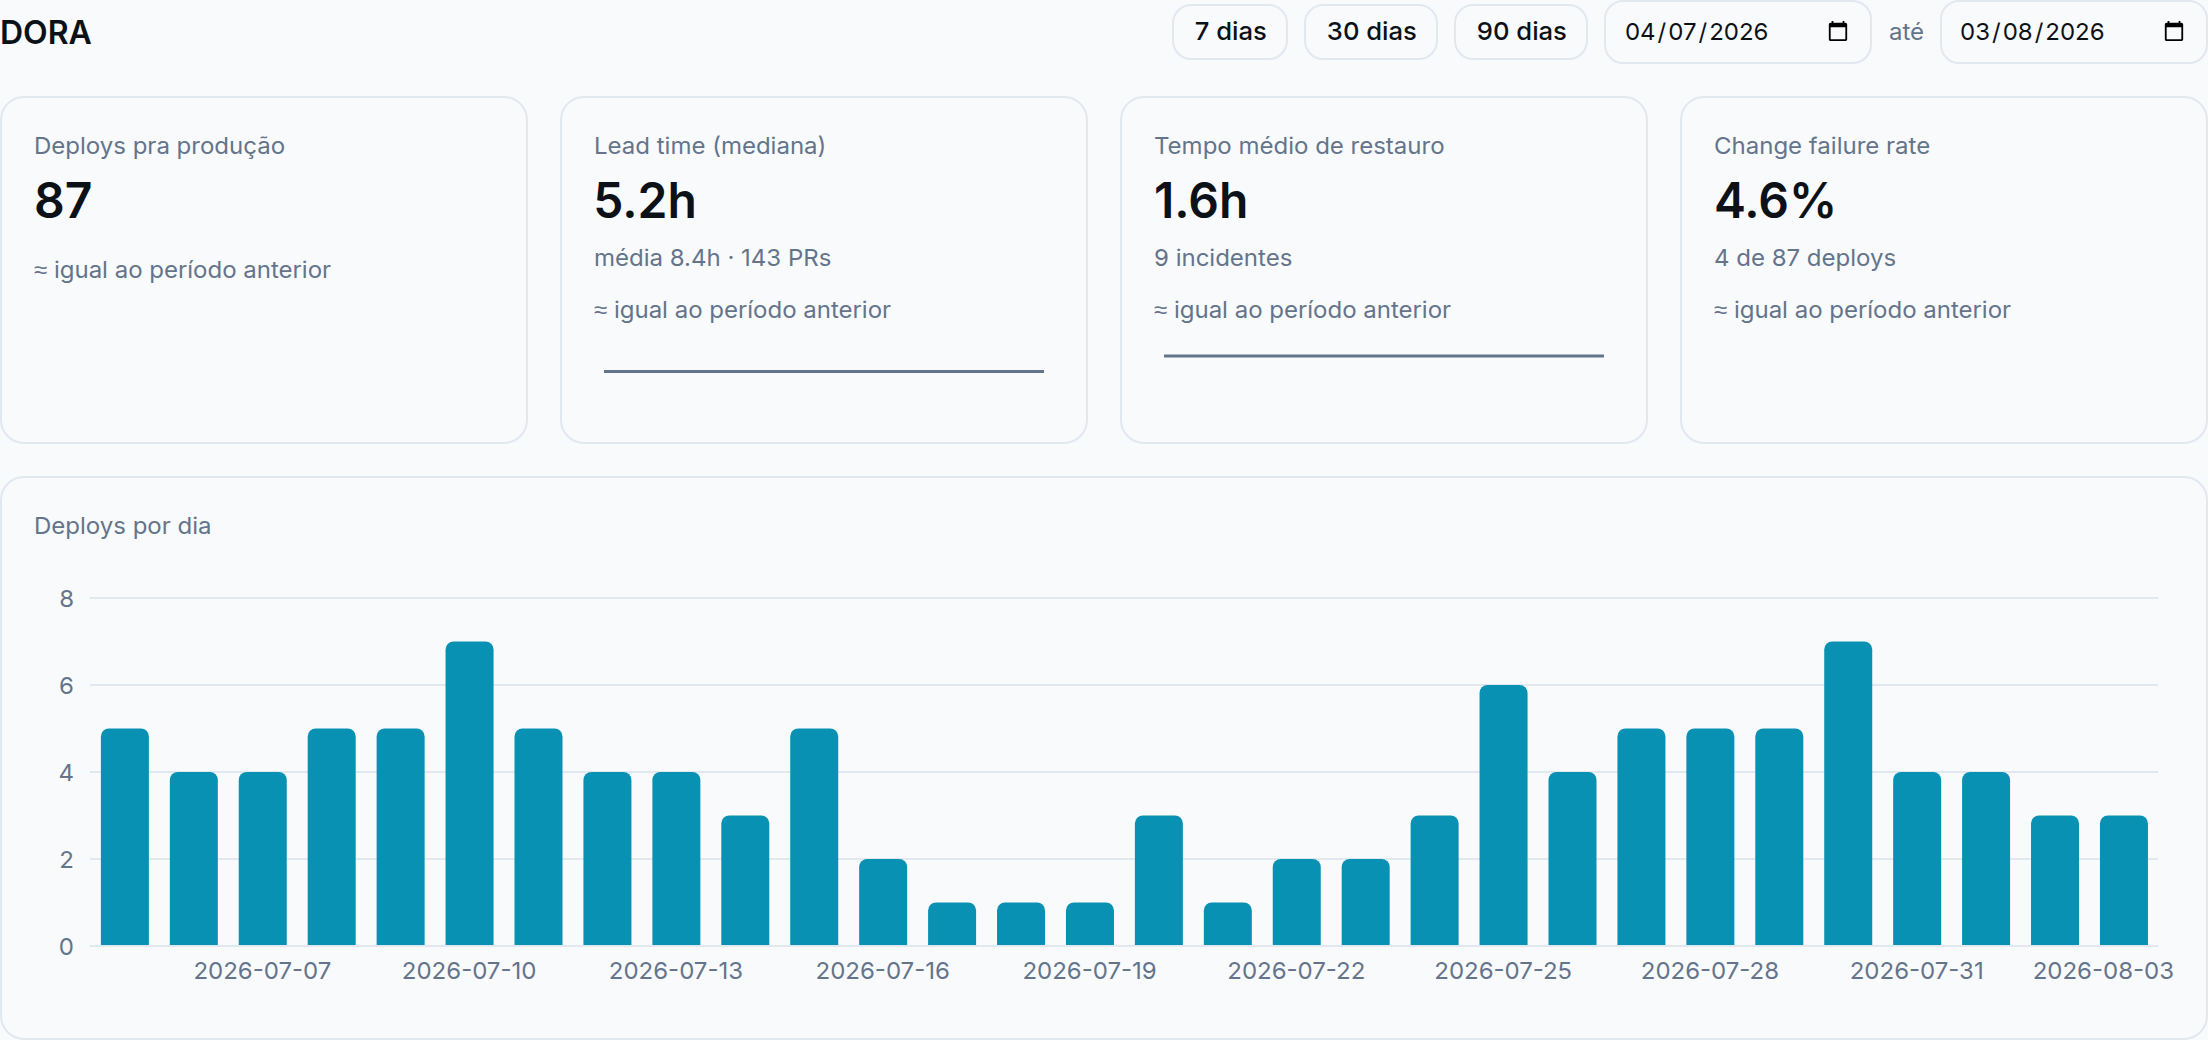
Dado ilustrativo, apenas para demonstração.
Perguntas sobre mean time to restore
O MTTR só conta incidente causado por deploy?
Não — o MTTR conta todo incidente resolvido no período, seja ele ligado a um deploy recente ou não. O change failure rate é a métrica que especificamente liga incidente a deploy; o MTTR é sobre velocidade de recuperação em geral.
E se um incidente reabrir depois de marcado como resolvido?
Só entra na conta incidente com timestamp de resolução dentro do período — se um conserto não se sustenta e o incidente reabre, isso normalmente vira um novo registro de incidente no Waroom/incident.io com seu próprio tempo de restauro, não uma edição retroativa do primeiro.
Por que a média e a mediana do MTTR às vezes parecem tão diferentes?
Uma indisponibilidade bem longa puxa a média pra cima bastante sem mudar como é um incidente típico — a mediana resiste mais a isso. Olhar as duas é mais honesto do que escolher a que parece melhor.
Veja seu próprio mean time to restore
Começar grátis