GUIA
Flow Distribution (Distribuição de Fluxo): O Que É e Como Calcular
Uma métrica de fluxo central — a mistura de trabalho que um time realmente conclui, quebrada por categoria.
O que mede
Flow distribution é a proporção do trabalho concluído que cai em cada categoria que seu time acompanha — geralmente alguma versão de trabalho de feature, defeitos/bugs, dívida técnica, e trabalho de risco/compliance. O Flow Framework define quatro categorias oficiais; na prática, a maioria dos times acaba precisando de uma quinta ou de sua própria variação, porque as quatro originais não cobrem bem trabalho tipo toil operacional recorrente, que não é bem um defeito nem bem uma feature.
Por que importa
Um número de throughput sozinho esconde a história que a flow distribution conta: um time que "entregou 40 itens" mas onde 30 deles eram correção de bug está numa posição bem diferente de um onde 30 eram feature nova. Acompanhar essa divisão ao longo do tempo transforma "estamos ocupados" em "estamos gastando a maior parte da nossa capacidade em defeito nesse trimestre" — ponto de partida pra uma conversa de verdade sobre prioridades, não só uma sensação vaga de que o time está sobrecarregado.
Também é um dos jeitos mais honestos de defender um investimento que geralmente não é visível até já virar crise. "Precisamos pagar dívida técnica" é fácil de despriorizar quando é uma opinião; "dívida técnica cresceu de 10% pra 30% do nosso trabalho concluído em dois trimestres, e o trabalho de feature caiu na mesma proporção" é uma tendência que uma conversa de roadmap de fato precisa responder.
Como calcular
Classifique cada item concluído numa categoria, e então expresse a fração de cada categoria como porcentagem do trabalho total concluído num período. A parte que exige uma decisão de verdade é onde ficam as fronteiras de categoria — tipo de issue e labels no seu rastreador são um ponto de partida, mas raramente se encaixam de forma limpa sozinhos; a maioria dos times acaba precisando de regras explícitas (se o campo X contém Y, é categoria Z) pra chegar numa quebra em que as pessoas de fato confiam.
Um exemplo rápido: um time conclui 60 itens num mês — 12 Bug, 30 Feature, 10 Dívida Técnica, 6 Toil, 2 Risco. Flow distribution expressa isso como frações: 20% Bug, 50% Feature, 17% Dívida Técnica, 10% Toil, 3% Risco. Sozinha, a divisão de um mês não diz muita coisa — o sinal útil é observar essas frações se mexerem (ou não) trimestre a trimestre.
Uma armadilha comum
Definições de categoria que mudam ao longo do tempo — uma regra silenciosamente apertada ou afrouxada sem ninguém decidir isso — fazem um gráfico de distribuição parecer que as prioridades mudaram quando na verdade foi a régua de medir que mudou. Trate uma mudança nas regras como uma anotação no próprio gráfico (a Timeline do moasy.tech existe em parte pra isso), não uma edição silenciosa, pra uma mudança real no que o time trabalha não ser confundida com uma redefinição do que uma categoria significa.
Como o moasy.tech calcula isso
O moasy.tech classifica trabalho concluído em Bug, Feature, Dívida Técnica, Toil e Risco — cinco categorias em vez das quatro originais do Flow Framework, mais perto de como times de engenharia realmente descrevem seu trabalho, incluindo uma categoria ("Toil") pra carga operacional recorrente que não se encaixa bem como defeito nem feature. As categorias vêm de regras semânticas que você mesmo configura, não uma taxonomia fixa: defina um padrão pra empresa inteira, depois deixe cada time sobrescrever, já que o que conta como Toil pra um time pode ser Feature pra outro. A mesma categorização também pode ser quebrada um nível a mais, por épico, pra ver qual iniciativa específica está gerando mais de qualquer categoria.
Veja as outras métricas de fluxo no guia completo, ou a implementação inteira na página de Flow Metrics.
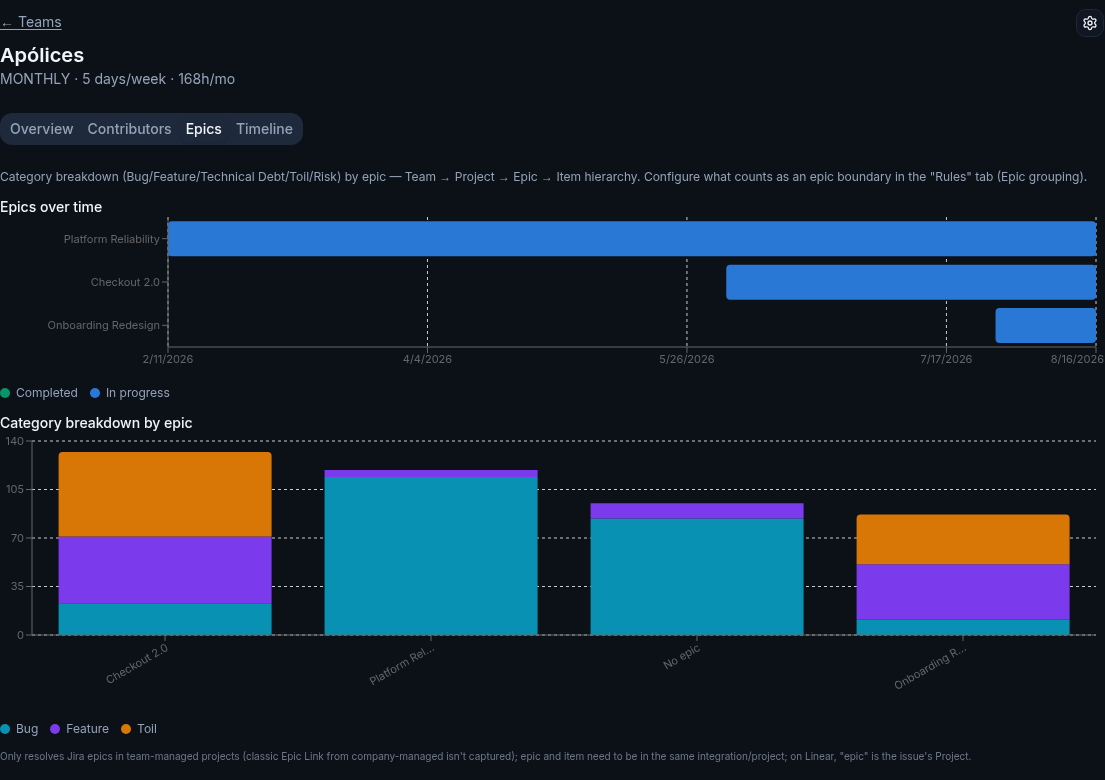
Dado ilustrativo, apenas para demonstração.
Perguntas sobre flow distribution
Por que o moasy.tech usa 5 categorias em vez das 4 do Flow Framework?
Porque "Toil" — trabalho operacional recorrente tipo deploy manual, pedido de acesso, ou manutenção de rotina — não se encaixa de forma limpa em feature, defeito, dívida ou risco, e forçar isso num desses buckets deixava a quebra menos útil, não mais precisa.
A mesma categoria pode significar coisas diferentes em times diferentes?
Sim, de propósito — a regra do próprio time tem precedência sobre um padrão da empresa, já que o que um time trata como Toil, outro pode tratar como Feature, e forçar uma única definição fixa em todo time costuma produzir números em que ninguém na ponta confia.
Existe uma divisão "saudável" de flow distribution?
Não uma universal — depende da maturidade do produto e do contexto de negócio (um produto jovem geralmente pende pra Feature, um mais velho pra Dívida Técnica e Toil). Mais útil que uma meta fixa é a tendência: uma categoria subindo de forma constante trimestre a trimestre vale uma conversa independente de qual seria o número "certo".
Veja sua própria flow distribution
Começar grátis