GUIA
Change Failure Rate (Taxa de Falha de Mudança): O Que É e Como Calcular
Uma das 4 métricas DORA — a fração de deploys que acabam causando um incidente.
O que mede
Change failure rate é a porcentagem de deploys em produção que resultam num serviço degradado, uma indisponibilidade, ou qualquer outro incidente que exija remediação. É a métrica que mantém as outras três honestas — frequência de deploy e lead time recompensam velocidade, e change failure rate é a checagem de que a velocidade não está custando estabilidade.
Por que importa
Frequência de deploy e lead time podem os dois melhorar cortando caminho — pulando revisão, pulando teste, entregando mesmo assim. Change failure rate é o número que expõe se foi isso que de fato aconteceu. Um time pode parecer excelente nas outras 3 métricas DORA enquanto acumula indisponibilidade silenciosamente, e change failure rate é o único número que pegaria isso. Também é a métrica mais diretamente ligada ao que o usuário sente: ele raramente percebe com que frequência você faz deploy, mas com certeza percebe quando um deploy quebra algo que ele estava usando.
Importa por um segundo motivo, menos óbvio: um change failure rate alto é caro de um jeito que se acumula. Todo deploy que falha não custa só o incidente em si — também costuma deixar o time mais lento depois, conforme as pessoas ficam mais cautelosas, adicionam mais checagem manual, e agrupam mudanças de forma mais conservadora pra evitar a próxima. Um time que mantém a taxa de falha baixa consegue se dar ao luxo de ir rápido com confiança; um que não consegue acaba pagando a velocidade com cautela depois.
Como calcular
Divida o número de deploys que causaram um incidente pelo total de deploys no mesmo período, expresso como porcentagem. A parte que exige uma decisão de verdade é o que conta como "causou" — a abordagem mais limpa é só contar um incidente que começou dentro de uma janela definida depois de um deploy (uma hora, por exemplo), pra problemas sem relação que acontecem por coincidência na mesma hora não inflarem o número.
Um exemplo rápido: um time entrega 50 deploys num mês, e 3 deles são seguidos por um incidente dentro da janela configurada. O change failure rate do mês é 3 ÷ 50 = 6%. É essa a conta inteira — o trabalho está todo em decidir, com antecedência, o que "causou" e o que "dentro da janela" significam, pra o número significar a mesma coisa todo mês em vez de mudar de definição silenciosamente.
Performance elite vs. típica
A pesquisa da DORA consistentemente encontra times de elite e alta performance concentrados numa faixa baixa — bem abaixo de um terço dos deploys causando falha, muitas vezes bem menos — enquanto times de performance mais baixa ficam significativamente acima disso. Trate os cortes exatos como uma noção geral de escala, não um placar rígido, já que as faixas precisas mudaram um pouco entre diferentes anos do State of DevOps Report.
Uma armadilha comum
Uma janela de correlação estreita faz o change failure rate parecer melhor sem os deploys ficarem mais seguros de verdade — um incidente que aparece 90 minutos depois de um deploy, pouco depois de uma janela de 1 hora, ainda vem daquele deploy mesmo que a métrica não pegue isso. Existe um trade-off real aqui (uma janela larga demais começa a culpar deploy por problema sem relação nenhuma), mas vale a pena revisitar a janela de vez em quando em vez de tratar o valor escolhido de início como permanente.
Como o moasy.tech calcula isso
O moasy.tech atrela o change failure rate direto a incidentes, não a palpite a partir de label de ticket. Um deploy só conta como falha quando um incidente de verdade — sincronizado somente leitura do Waroom ou incident.io e classificado pelas suas próprias regras configuráveis (sobrescrita por time, com um padrão da empresa como fallback) — acontece dentro de uma janela configurável depois dele. O incident.io ainda não resolve um incidente pra um time específico do jeito que o Waroom resolve, e o change failure rate exige um incidente vinculado a um time, então o dado do incident.io sincroniza mas não entra nesse número até isso ser resolvido.
Veja as outras 3 métricas DORA no guia completo, ou a implementação inteira na página de DORA Metrics.
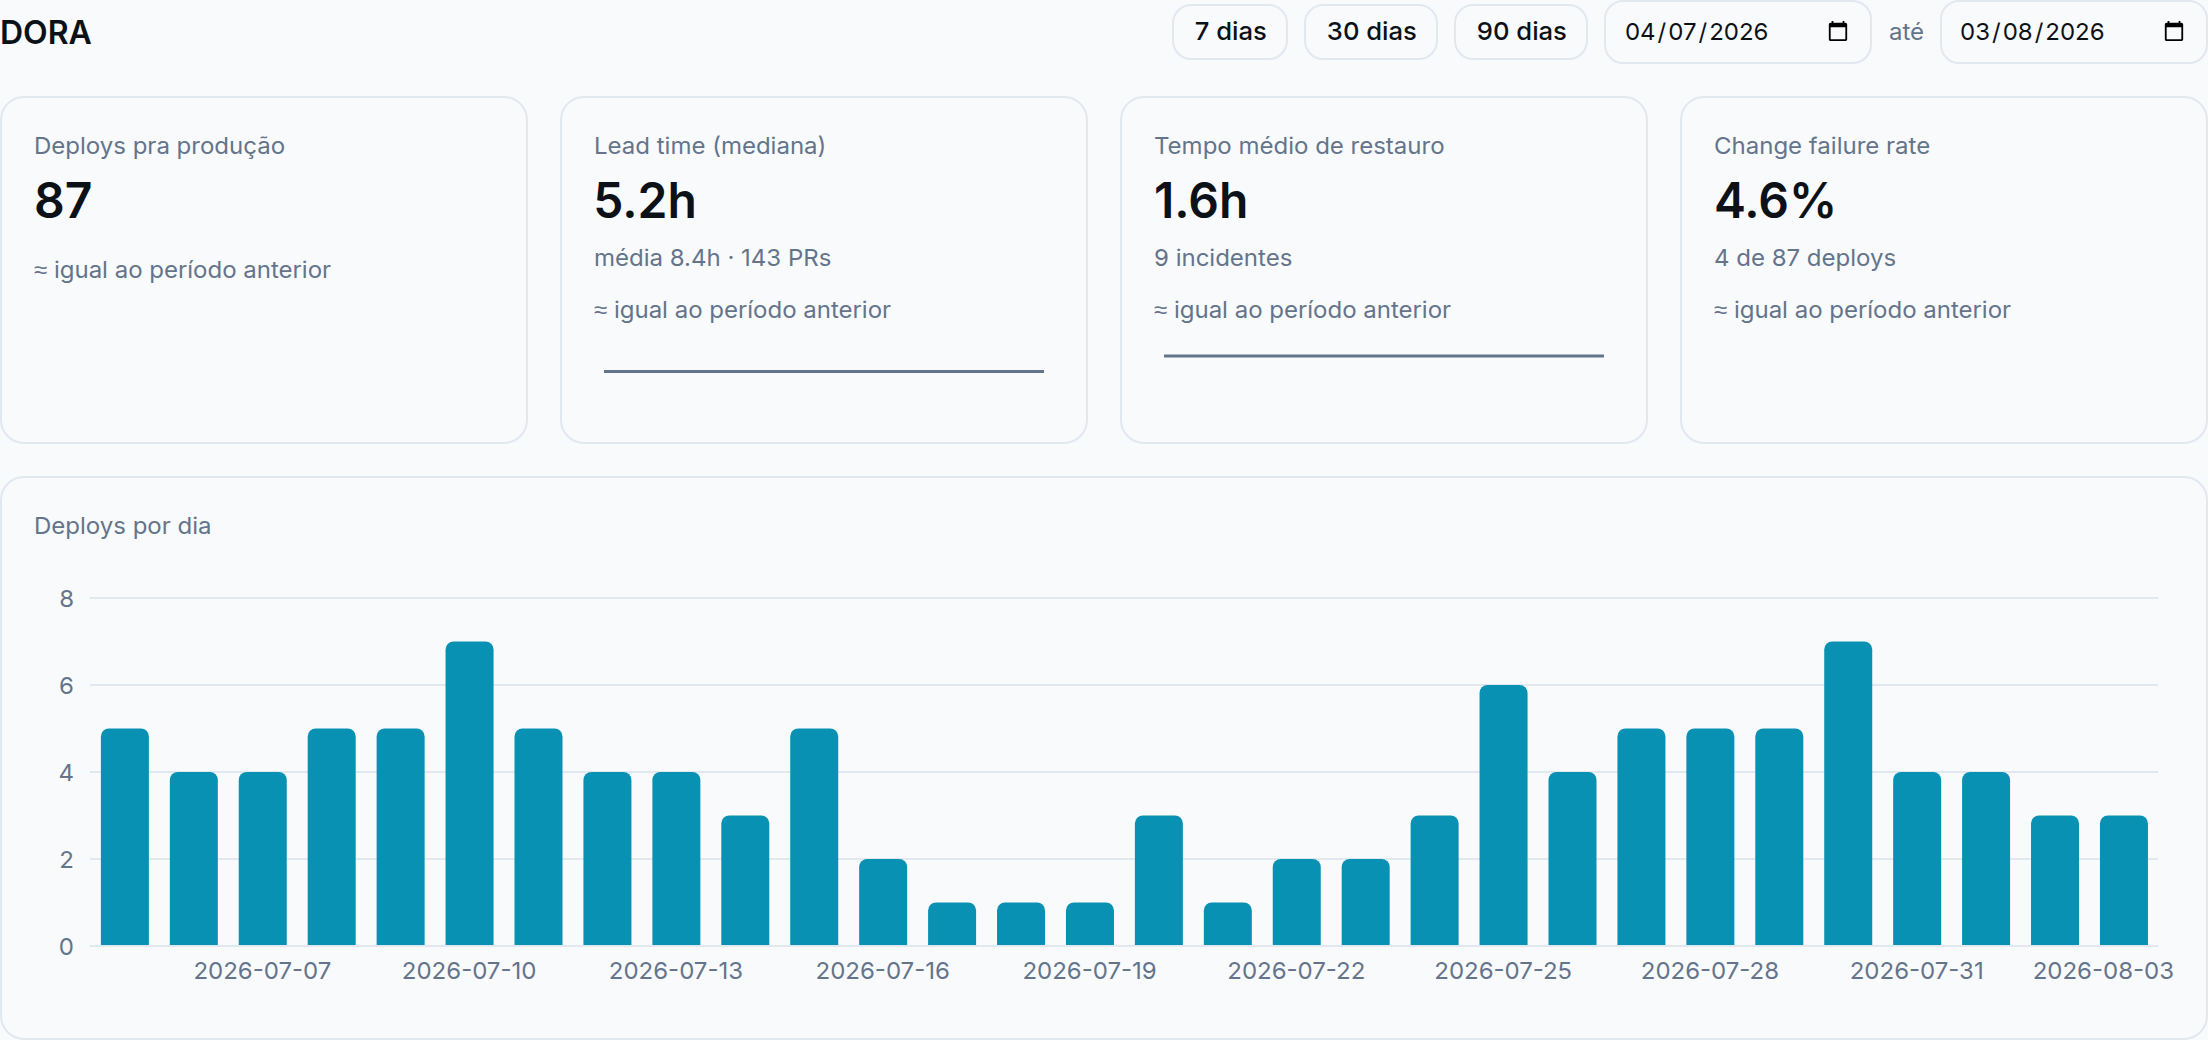
Dado ilustrativo, apenas para demonstração.
Perguntas sobre change failure rate
Change failure rate é a mesma coisa que contar ticket de bug?
Não — é atrelado a deploy, não a ticket. Um deploy só conta como falha quando um incidente de verdade acontece dentro de uma janela depois dele. Nem todo ticket de bug é um incidente de produção, e nem todo incidente vem de um deploy.
O que conta como "incidente" pra essa métrica?
Isso é configurável, não fixo — regras de classificação de severidade (quais incidentes contam como falha de verdade versus só informativo) podem ser definidas por time, com um padrão da empresa como fallback, já que o que um time trata como incidente de verdade pode ser diferente do limite de outro.
Isso é a mesma coisa que deployment success rate?
Não — deployment success rate olha só o status do deploy (o pipeline em si teve sucesso ou falhou), sem nenhuma ligação com incidente. Change failure rate é especificamente sobre deploy que chegou em produção com sucesso mas causou um incidente de verdade depois — um deploy pode ter sucesso pela primeira medida e ainda contar como falha por essa.
Veja seu próprio change failure rate
Começar grátis